 Genius-bot · 12 минут чтения
API нейросети — это не обязательно схема «отправил запрос и сразу получил готовый файл». Для тяжёлых операций запрос может только поставить задачу в обработку: сервер принимает параметры, создаёт задачу, возвращает её идентификатор, а готовый результат появляется позже. Такой подход особенно важен для генерации видео, анимации, музыки и других операций, которые нельзя надёжно выполнить за время одного HTTP-соединения.
Если вы раньше работали только с синхронными API, здесь меняется сама логика программы. Вместо одного вызова появляются несколько этапов: запуск, сохранение ID, проверка состояния и получение результата. Ниже разберём, что такое api нейросети на практике, как устроена очередь и где в коде появляется задача, которая живёт дольше исходного HTTP-запроса. Получить API-ключ можно после входа в разделе API.
Для примеров будем использовать API сервиса с базовым адресом https://genius-bot.ru/wp-json/genius/v1. Авторизация выполняется через заголовок Authorization: Bearer <ключ>. Ключ выдаётся в разделе API и показывается один раз, поэтому в рабочем коде его лучше хранить в переменной окружения, а не записывать непосредственно в исходник.
 1. Что происходит между запросом и готовым файлом
На уровне HTTP запрос выглядит привычно: клиент отправляет POST на маршрут API, сервер принимает параметры и возвращает ответ. Но сам ответ не обязан содержать готовый файл. Для ресурсоёмкой операции серверу нужно сначала зарегистрировать работу как отдельную задачу, чтобы вычисление могло продолжаться независимо от соединения клиента.
Упрощённо последовательность выглядит так: клиент → POST /generate → создание задачи → очередь обработки → выполнение операции → готовый результат. Клиенту при этом не нужно держать первое соединение открытым до конца генерации. Он получает идентификатор и использует его для последующих запросов.
Это отличается от классического синхронного вызова функции. В синхронной модели программа вызывает функцию и ждёт возвращаемое значение:
result = generate(data)
print(result)
В асинхронной модели между вызовом и результатом появляется отдельный объект — задача. Программа сначала запускает её:
task = create_task(data)
task_id = task["id"]
а затем отдельно спрашивает сервер, что с ней произошло. Поэтому понятия «HTTP-запрос» и «задача» здесь нельзя считать одним и тем же. Запрос может завершиться за секунды, тогда как созданная им задача продолжит выполняться после закрытия соединения.
Именно эта модель позволяет API обслуживать операции с разной продолжительностью. Например, в доступном наборе есть генерация изображения, редактирование фотографии, увеличение качества, создание видео, музыки, озвучки и говорящего аватара. Их стоимость также различается, поэтому клиент сначала запускает конкретную операцию, а затем получает состояние именно созданной задачи.
| Операция | Цена за запуск |
|---|---|
| Картинка по описанию (image) | 9 ₽ |
| Оживить фото (photo-video) | 25 ₽ |
| Изменить фото по описанию (image-edit) | 35 ₽ |
| Увеличить качество фото (upscale) | 50 ₽ |
| Создать музыку (music) | 59 ₽ |
| Видео по описанию (video) | 119 ₽ |
| Говорящий аватар (avatar) | 120 ₽ |
Цены в таблице указаны за один запуск. Для озвучки текста действует отдельное правило: стоимость составляет 18 ₽ за 1000 знаков. Оплата производится за запуск операции, без абонентской платы и минимального платежа.
 2. Синхронный ответ и очередь задач: где проходит граница
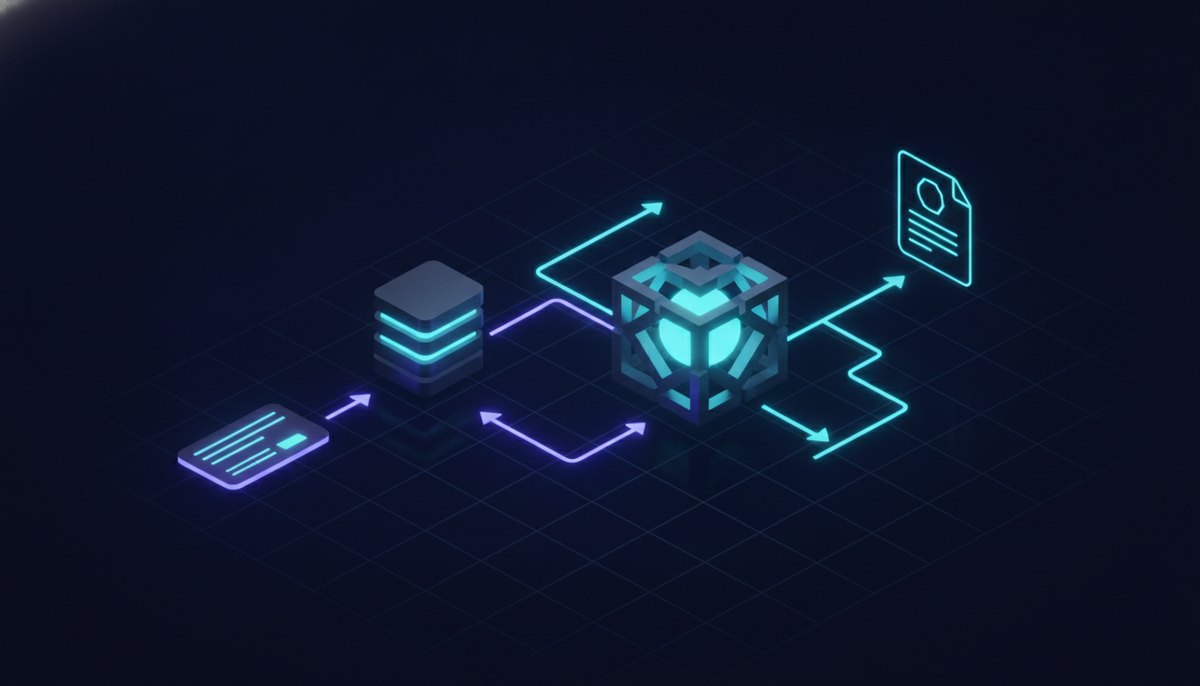
Синхронный API удобен там, где результат можно вернуть непосредственно в ответе. Клиент отправляет запрос, сервер выполняет операцию, после чего HTTP-ответ содержит результат. В таком сценарии код линейный: запрос, ожидание, обработка ответа.
Для тяжёлой нейросетевой операции такая схема создаёт ненужную зависимость между вычислением и HTTP-соединением. Пока модель работает, клиент должен продолжать ждать, а серверу приходится связывать жизненный цикл вычисления с конкретным соединением. При очереди задач эта связь разрывается.
В модели с очередью POST /generate означает скорее «создай работу с такими параметрами», чем «верни мне готовый результат прямо сейчас». После принятия запроса сервер выдаёт идентификатор. Дальше клиент может закрыть соединение, заняться другой работой и вернуться к задаче позже.
У такого подхода есть ещё одно практическое преимущество: клиент не обязан угадывать продолжительность конкретной операции. Вместо большого тайм-аута в одном запросе используется небольшое количество независимых HTTP-запросов. Это особенно удобно в веб-приложении, где пользовательский запрос не должен удерживать серверный процесс в ожидании генерации.
Как работает api нейросети в такой архитектуре, можно представить через два уровня. HTTP отвечает за обмен сообщениями между клиентом и API, а очередь и задача отвечают за жизненный цикл самой операции. Первый уровень сообщает: «запрос принят», второй постепенно доводит работу до состояния «результат готов».
У сервиса есть ограничение частоты: не более 60 запросов в минуту на один ключ. Это ограничение относится к HTTP-запросам к API, поэтому при проектировании частого опроса состояния нужно учитывать его вместе с количеством запускаемых задач.
 3. Идентификатор задачи и её состояния
Идентификатор задачи нужен для того, чтобы сервер мог однозначно связать последующие обращения с конкретной операцией. После запуска клиент сохраняет ID. Затем он обращается к маршруту GET /tasks/{id}, подставляя полученный идентификатор.
Логика программы при этом меняется всего в одном важном месте: результат больше нельзя искать в ответе на POST /generate. Ответ запуска используется для получения идентификатора, а состояние и результат запрашиваются отдельным методом. В псевдокоде это выглядит так:
response = POST /generate
task_id = response.id

while task_is_not_ready:
    status = GET /tasks/{task_id}

return result
Конкретные названия состояний не стоит придумывать на стороне клиента: приложение должно ориентироваться на фактический ответ API. Практически важно разделять как минимум три ситуации: задача ещё обрабатывается, задача завершилась с результатом и задача завершилась ошибкой. В каждом случае программа должна вести себя по-разному.
Для ожидающего состояния клиенту не нужен новый запуск операции. Нужно продолжать работу с тем же ID. Повторный POST /generate создаст другую операцию и может привести к повторной оплате запуска, тогда как проверка GET /tasks/{id} только запрашивает информацию о существующей задаче.
Эта деталь особенно важна в пользовательском интерфейсе. Кнопка «создать» должна запускать задачу один раз, а индикатор прогресса или фоновый обработчик — проверять её состояние. Если смешать эти две функции, временная ошибка сети может привести к повторному запуску вместо обычной повторной проверки.
Результат задачи также следует сохранять после получения. Это позволяет не обращаться к API повторно без необходимости. Если приложение использует базу данных, минимальная запись может содержать внутренний ID пользователя, ID задачи API, тип операции и состояние, полученное от API.
 4. Вебхук: кто кому звонит и зачем
Постоянно опрашивать GET /tasks/{id} необязательно. Для запуска операции можно передать параметр callback_url. Когда задача будет готова, API отправит на этот адрес POST-запрос.
В этой схеме направление общения меняется. При запуске клиент обращается к API: «создай задачу». После завершения API сам обращается к серверу клиента: «задача готова». Такой механизм называется webhook и особенно удобен, когда результат может появиться не сразу.
Например, веб-приложение может создать задачу и записать её ID в базу. Пользователю не нужно держать страницу открытой и выполнять десятки запросов для проверки состояния. Когда API отправит уведомление на callback_url, приложение обработает его и обновит запись о задаче.
Для вебхука нужен публично доступный HTTP-адрес вашего приложения, который умеет принимать POST. Сам обработчик должен быть рассчитан на повторные уведомления и проверять, к какой задаче относится полученное событие. Конкретную бизнес-логику после получения webhook приложение определяет самостоятельно.
Polling и webhook решают одну задачу разными способами. При polling клиент периодически спрашивает API о состоянии, а при webhook сервер API сообщает о готовности сам. Если операция создаётся редко и проверка не создаёт нагрузки, polling проще; если задач много и их выполнение может занимать заметное время, webhook позволяет не делать постоянные проверки.
При этом webhook не меняет саму модель задачи. У приложения всё равно есть идентификатор операции и её состояние. Меняется только способ узнать, что состояние изменилось.
 5. Ошибки на каждом этапе и что они означают
В асинхронной схеме ошибка может произойти не только при создании задачи. Поэтому полезно разделять ошибки транспорта, ошибки запуска и ошибки самой операции. Например, отсутствие соединения с API означает, что клиент не получил нормальный HTTP-ответ, а ошибка авторизации означает уже другую проблему — сервер смог обработать запрос, но ключ не был принят.
Первое, что стоит проверить при проблеме с API, — адрес запроса и заголовок авторизации. Базовый адрес сервиса — https://genius-bot.ru/wp-json/genius/v1, а ключ передаётся как Authorization: Bearer <ключ>. Если ключ хранится в переменной окружения, в журнал приложения нельзя без необходимости выводить сам заголовок целиком.
Следующий уровень — ошибка запуска. Если POST /generate не создал задачу, у клиента нет корректного ID, поэтому опрашивать GET /tasks/{id} бессмысленно. Код должен сначала убедиться, что запуск прошёл успешно и идентификатор действительно получен.
После успешного запуска возможна ошибка уже внутри задачи. Это принципиально отличается от ошибки HTTP-запроса на запуск: задача существует, но её результат не был получен. Поэтому обработчик состояния должен уметь отличать обычное ожидание от конечного состояния с ошибкой.
Ещё один тип проблемы возникает при превышении ограничения частоты. Один ключ может выполнять не более 60 запросов в минуту. Если приложение проверяет несколько тысяч задач слишком часто, проблема будет не в самой нейросетевой операции, а в архитектуре клиента: интервал опроса нужно выбирать с учётом количества одновременно выполняющихся задач.
Наконец, не стоит считать любой повтор запроса безопасным. Для GET /tasks/{id} повторная проверка относится к уже существующей задаче. Для POST /generate повтор может означать новый запуск операции, поэтому повторять его автоматически после сетевой ошибки следует только после того, как приложение понимает, был ли первоначальный запрос принят.
6. Минимальный рабочий цикл на Python
Начнём с самого короткого HTTP-примера на curl. В нём показан запуск операции через POST /generate; конкретные параметры операции зависят от того, что требуется запустить. Ключ передаётся в стандартном заголовке Authorization.
curl -X POST "https://genius-bot.ru/wp-json/genius/v1/generate" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "operation": "image",
    "prompt": "Горный пейзаж утром"
  }'
Главная идея примера не в конкретном тексте запроса, а в разделении запуска и получения результата. После успешного запуска приложение должно сохранить ID задачи. Затем этот ID используется в запросе к /tasks/{id}.
На Python базовый цикл можно построить с библиотекой requests. Важный момент — функция запуска не должна сама считать, что получила готовое изображение или другой конечный файл. Она получает ответ API, извлекает идентификатор задачи и передаёт управление следующему этапу.
import os
import time
import requests

BASE_URL = "https://genius-bot.ru/wp-json/genius/v1"
API_KEY = os.environ["GENIUS_API_KEY"]

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json",
}

payload = {
    "operation": "image",
    "prompt": "Горный пейзаж утром"
}

response = requests.post(
    f"{BASE_URL}/generate",
    headers=headers,
    json=payload,
    timeout=30,
)
response.raise_for_status()

data = response.json()
task_id = data["id"]

while True:
    response = requests.get(
        f"{BASE_URL}/tasks/{task_id}",
        headers=headers,
        timeout=30,
    )
    response.raise_for_status()

    task = response.json()

    if task["status"] == "completed":
        result = task.get("result")
        print(result)
        break

    if task["status"] == "failed":
        raise RuntimeError(task)

    time.sleep(3)
Этот код показывает именно архитектурный цикл: запуск → ID → проверка → результат. В реальном приложении названия полей ответа нужно сопоставить с фактическим JSON, который возвращает API, а обработку конечных состояний сделать явной.
Интервал в три секунды здесь является примером, а не обязательным значением API. Его можно менять в зависимости от количества задач и требований приложения, не забывая об ограничении 60 запросов в минуту на ключ. При большом числе параллельных задач лучше считать общий объём запросов, а не интервал для одной задачи изолированно.
Файловый сценарий строится по той же модели. Для загрузки используется POST /uploads, который возвращает ссылку на загруженный файл. Затем эта ссылка может использоваться при запуске соответствующей операции через POST /generate, после чего задача снова отслеживается по идентификатору.
У сервиса есть и другой вариант интеграции для чатовых сценариев. Маршруты POST /chat/completions и GET /models работают в том же формате, что и OpenAI API: в клиентской библиотеке достаточно изменить base_url и ключ. Для чата указана стоимость 40 ₽ за миллион токенов запроса и 400 ₽ за миллион токенов ответа.
Таким образом, нейросеть через API — это не просто вызов модели из программы. Для тяжёлых операций разработчик работает с жизненным циклом задачи: создаёт её, получает ID, отслеживает состояние и забирает результат либо получает уведомление через webhook. После такого разделения код становится понятнее: HTTP-запрос отвечает за обмен с API, а задача — за длительную работу внутри сервиса.
Частые вопросы
Почему нельзя просто дождаться ответа на POST /generate?
Потому что для операций, выполняющихся дольше обычного HTTP-запроса, используется модель задач. Запрос запускает операцию и возвращает идентификатор, а состояние и результат затем запрашиваются через GET /tasks/{id}.
Зачем нужен ID задачи?
ID связывает первоначальный запуск с последующими проверками. По нему API понимает, какую именно задачу нужно показать клиенту и какой результат вернуть после завершения.
Обязательно ли использовать webhook?
Нет. В API предусмотрен необязательный параметр callback_url. Без него приложение может самостоятельно проверять состояние через GET /tasks/{id}.
Можно ли загрузить файл перед запуском операции?
Да. Для этого предусмотрен маршрут POST /uploads, который используется для загрузки файла и получения ссылки. Эту ссылку затем можно использовать в соответствующем запросе на запуск операции.
Сколько стоит использование API?
Оплата производится за запуск операции, без абонентской платы и минимального платежа. Стоимость зависит от операции: например, image стоит 9 ₽ за запуск, image-edit — 35 ₽, video — 119 ₽, а tts — 18 ₽ за 1000 знаков. При выпуске первого ключа на баланс начисляется 50 ₽ для пробного использования.
Где взять ключ и какой формат авторизации использовать?
Ключ выдаётся после входа в разделе API и показывается один раз. В запросах он передаётся в формате Authorization: Bearer <ключ>. Раздел с настройками API и ключом находится по адресу сервиса.