 Genius-bot · 10 минут чтения
Если у контентного проекта уже есть поток публикаций, text to speech api позволяет превратить аудиоверсию текста в обычный этап публикации: статья вышла — для неё подготовился аудиофайл, а на странице появился плеер. Это особенно удобно там, где новые материалы появляются регулярно, а отдельный монтаж каждого выпуска быстро превращается в рутинную работу.
В этой статье разберём именно контентный сценарий: автоматическую озвучку статей, аудиоверсию рассылки и сборку выпуска подкаста из уже написанного текста. Отдельно посчитаем стоимость ста статей, разберём, как связать расходы с дочитываниями, и покажем, какие места требуют ручной проверки даже при полностью автоматическом процессе. Раздел с API и выпуском ключа находится в личном кабинете сервиса.
 Зачем тексту аудиоверсия и кто её слушает
Аудиоверсия не должна восприниматься как отдельный материал, который редакция пишет с нуля. Для контентного проекта исходником уже служит готовая статья. Задача TTS — взять этот текст, получить озвучку и добавить её к публикации как ещё один способ потребления того же материала.
У такого подхода есть практическое преимущество: редакционный процесс не меняется радикально. Автор по-прежнему пишет статью, редактор проверяет текст, публикационная система создаёт страницу, а после этого отдельный автоматизированный шаг готовит аудио. Если в проекте выходит 100 статей в месяц, не требуется вручную собирать 100 отдельных аудиотреков.
Потенциальная аудитория аудиоверсий тоже отличается от обычных читателей не демографией, которую имеет смысл угадывать, а способом использования контента. Человек может открыть статью во время дороги, прогулки или бытовой работы, когда читать экран неудобно. Другой сценарий — пользователь сначала слушает начало, а затем переходит к тексту за конкретными деталями.
Для аналитики здесь важно не смешивать метрики. Прослушивание, запуск плеера, время воспроизведения и дочитывание страницы — разные события. Если цель проекта заключается именно в увеличении глубины потребления контента, то TTS имеет смысл оценивать не по количеству сгенерированных файлов, а по тому, как аудио меняет поведение пользователей.
Для этого можно добавить к обычной веб-аналитике события вроде audio_play, audio_25, audio_50, audio_90 и связать их с URL статьи. Названия событий здесь условные: конкретная система аналитики и формат отправки данных не относятся к API озвучки. Важен сам принцип — считать не только факт создания аудио, но и его использование.
Автоматическая озвучка при публикации: где встроить
Оптимальная точка интеграции — после того, как статья прошла редакционную проверку и получила финальный текст. До этого TTS может озвучить черновик, который затем изменится, и проект заплатит за повторную генерацию. Поскольку у озвучки цена указана за 1000 знаков, повторная обработка особенно заметна на большом объёме.
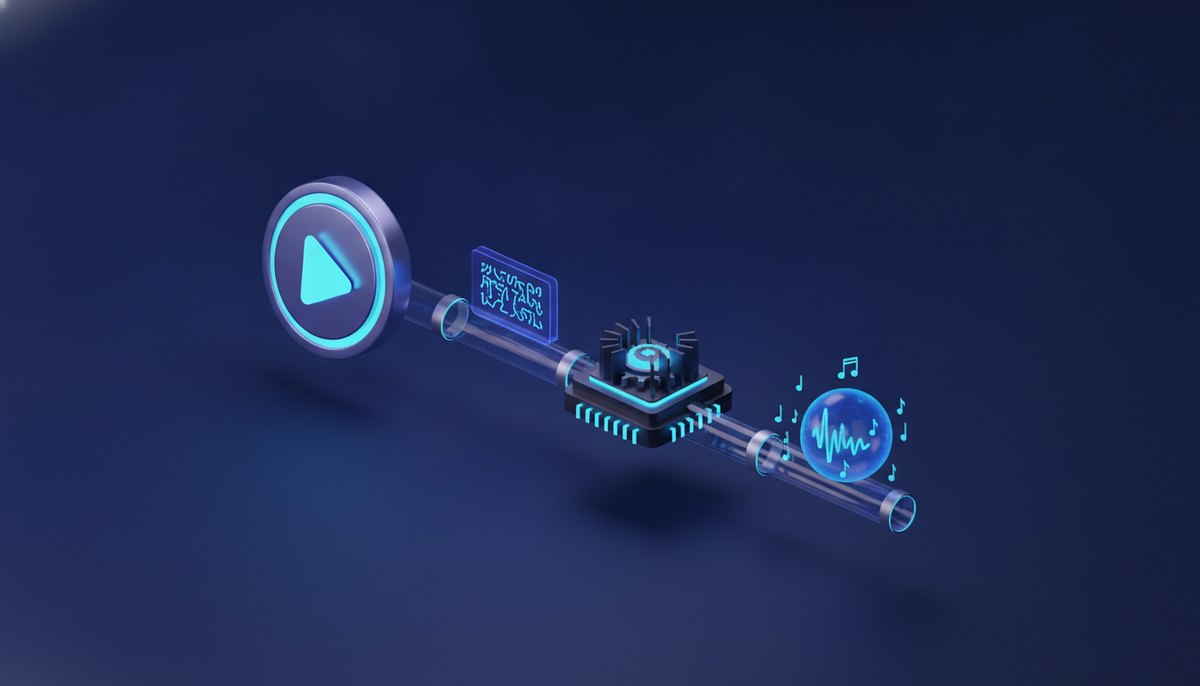
Схема получается простой: CMS сохраняет опубликованный текст, отдельный обработчик отправляет задачу на /generate, получает идентификатор задачи и затем проверяет её состояние через /tasks/{id}. Вместо постоянного опроса можно передать callback_url: когда задача готова, сервис отправляет на этот адрес POST.
Авторизация выполняется заголовком Authorization: Bearer <ключ>. Ключ выдаётся в разделе API после входа и показывается один раз, поэтому его лучше хранить в секретах серверного окружения, а не в шаблоне страницы или JavaScript-коде браузера.
Перед внедрением полезно получить список доступных операций через GET /services. Это одновременно проверка ключа и способ не зашивать цены непосредственно в код приложения.
curl -X GET "https://genius-bot.ru/wp-json/genius/v1/services" \
  -H "Authorization: Bearer $GENIUS_API_KEY"
Для проверки баланса используется отдельный маршрут:
import os
import requests

BASE_URL = "https://genius-bot.ru/wp-json/genius/v1"
headers = {
    "Authorization": f"Bearer {os.environ['GENIUS_API_KEY']}"
}

response = requests.get(f"{BASE_URL}/balance", headers=headers)
response.raise_for_status()

print(response.json())
В примерах выше намеренно не зафиксирован выдуманный JSON для /generate. В предоставленной документации указан сам маршрут запуска операции, авторизация и жизненный цикл задачи, но не приведена схема тела запроса для TTS. Поэтому в рабочем проекте параметры запуска нужно брать из актуальной справки конкретной операции, а не копировать предположительные поля вроде text или voice.
После запуска задача получает идентификатор. Приложение может проверять его через GET /tasks/{id} или передать callback URL и дождаться входящего POST. Второй вариант удобнее для публикационной очереди: сервер не тратит запросы на постоянный polling, а обработчик начинает следующий шаг только после готовности результата.
Есть и ограничение по частоте: на один ключ допускается не более 60 запросов в минуту. Для контентного проекта это означает, что очередь стоит учитывать заранее. Например, пакет из 100 статей нельзя бездумно отправлять одновременно одним ключом, особенно если рядом выполняются другие операции.
Сколько стоит озвучить сто статей
Для TTS цена составляет 18 ₽ за 1000 знаков. Это цена одного запуска озвучки, причём единица расчёта именно 1000 знаков. Поэтому стоимость статьи зависит не от количества страниц в CMS и не от количества абзацев, а от объёма текста, который передаётся на озвучку.
| Объём одной статьи | Стоимость одной озвучки | 100 статей |
|---|---|---|
| 2 000 знаков | 36 ₽ | 3 600 ₽ |
| 4 000 знаков | 72 ₽ | 7 200 ₽ |
| 6 000 знаков | 108 ₽ | 10 800 ₽ |
| 8 000 знаков | 144 ₽ | 14 400 ₽ |
| 10 000 знаков | 180 ₽ | 18 000 ₽ |
Расчёт простой: количество знаков делится на 1000 и умножается на 18 ₽. Если в редакции принято считать объём в символах вместе с пробелами, используйте одну и ту же методику при расчёте всех материалов, чтобы статистика затрат оставалась сопоставимой.
Например, при средней длине 6000 знаков 100 статей потребуют 600 × 1000 знаков, то есть 600 условных единиц по 1000 знаков. Стоимость составит 10 800 ₽. Это прямой расход на TTS по указанной цене; расходы на CMS, хранилище, разработку плеера и аналитику сюда не входят.
У сервиса нет абонентской платы и минимального платежа: оплата производится за запуск. При выпуске первого ключа на баланс начисляется 50 ₽ для пробы. Для контентной команды это удобно использовать как техническую проверку процесса до массовой постановки задач в очередь.
Окупаемость лучше считать через фактическое поведение аудитории. Допустим, проект потратил 10 800 ₽ на озвучку 100 статей. Если за период эти аудиоверсии дали 900 дополнительных целевых дочитываний, стоимость одного такого события составила бы 12 ₽. Если считать не дочитывания, а другой бизнес-показатель, формула меняется соответственно.
Здесь важно заранее определить, что именно считается дополнительным результатом. Если пользователь запустил аудио и всё равно полностью прочитал статью, нельзя автоматически записывать весь этот эффект в «прирост»: часть аудитории просто изменила способ потребления. Для более чистой оценки можно сравнивать группы публикаций с аудио и без него либо анализировать материалы до и после внедрения с учётом сезонности.
Плеер на странице: что важно кроме кнопки
Сам аудиофайл не решает задачу интерфейса. Пользователь должен сразу понимать, что именно он будет слушать, сколько длится материал и где находится управление воспроизведением. Минимальный вариант — название аудиоверсии, кнопка запуска и индикатор прогресса.
Для длинных статей полезно сохранять позицию воспроизведения. Если человек закрыл вкладку на 18-й минуте, повторный заход не должен обязательно начинать запись с нуля. Конкретная реализация зависит от сайта: позицию можно хранить локально на устройстве или в профиле пользователя.
Ещё один практический момент — не запускать аудио автоматически со звуком. Автовоспроизведение неожиданного голоса мешает пользователю и особенно неудобно на мобильных устройствах. Кнопка запуска должна быть явной, а текстовая версия статьи — оставаться доступной независимо от наличия аудио.
В аналитике имеет смысл различать хотя бы запуск и фактическое продолжительное прослушивание. Например, событие нажатия Play показывает интерес к аудиоверсии, но само по себе ничего не говорит о том, прослушал ли человек 20 секунд или почти весь материал.
Если аудиоверсия генерируется асинхронно, страница статьи не должна ждать её готовности. Сначала публикуется текст, затем появляется состояние «аудио готовится», а после получения результата через задачу или callback интерфейс обновляется. Такой подход не связывает скорость публикации статьи со временем генерации.
Подкаст из рассылки: сборка выпуска
Для рассылки процесс почти такой же, но исходником становится не отдельная статья, а набор текстовых блоков выпуска. Например, еженедельное письмо содержит пять материалов: из них можно собрать последовательность для аудиоверсии, сохранив порядок и короткие переходы между частями.
Здесь полезно сначала сформировать финальный текст выпуска, а уже потом отправлять его на озвучку. Если TTS запускается для каждого фрагмента отдельно, редакция получает больше контроля над структурой, но увеличивается число операций. Если выпуск озвучивается одним текстом, управление проще, зато сложнее отдельно заменить только один блок.
Практическая схема может выглядеть так: после закрытия редакционного дедлайна система собирает тексты, удаляет элементы, которые не предназначены для чтения вслух, создаёт задачу озвучки, получает результат и прикрепляет аудио к выпуску. Сам email при этом может содержать ссылку на веб-страницу с плеером, а не пытаться воспроизводить весь файл внутри письма.
Для подкаста из статьи нейросеть особенно полезна тогда, когда выпуск строится из уже опубликованного материала. Не нужно создавать отдельный сценарий, если задача состоит именно в переносе статьи в аудиоформат. Но редактору всё равно стоит проверить вступление, заголовки и элементы, рассчитанные исключительно на чтение с экрана.
При регулярном выпуске стоит вести журнал задач: URL или ID статьи, количество знаков, идентификатор задачи, дату запуска, статус и ссылку на результат. Это позволяет найти конкретную неудачную генерацию, не создавая аудио повторно для всего выпуска.
 Что не стоит озвучивать никогда
Первый кандидат — таблицы и технические конструкции, смысл которых теряется при линейном чтении. Если статья содержит 20 строк сравнительных данных, голосовая дорожка может превратиться в длинное перечисление, тогда как пользователь ожидает визуальное сравнение.
Второй случай — инструкции, где критически важна структура экрана. Пути меню, названия кнопок, фрагменты кода и параметры API часто требуют одновременного просмотра оригинала. Их можно оставить в текстовой версии, а в аудиоверсии кратко обозначить, что подробная инструкция находится на странице.
Не стоит автоматически озвучивать служебные элементы: подписи кнопок, SEO-текст, навигацию, юридические уведомления и повторяющиеся блоки. Если отправить в TTS весь HTML без предварительной очистки, в аудио может попасть информация, которая не является частью материала.
Отдельно нужно фильтровать персональные данные и внутренние редакционные заметки. Перед отправкой текста в API полезно иметь этап нормализации: выбрать основной контент, убрать техническую разметку и проверить, что в итоговой строке действительно находится публичная версия статьи.
Наконец, не каждую публикацию имеет смысл превращать в аудио только потому, что технически это возможно. Короткая новость из нескольких предложений, каталог с десятками характеристик или материал, построенный почти целиком на визуальных элементах, могут не дать того же эффекта, что обычная повествовательная статья. Решение здесь лучше принимать по данным собственного проекта, а не по формальному правилу «озвучивать всё».
 Частые вопросы
Сколько стоит TTS для статьи на 5000 знаков?
При цене 18 ₽ за 1000 знаков стоимость составит 90 ₽. Фактический расчёт для проекта стоит вести по тому объёму текста, который передаётся на озвучку.
Можно ли запускать озвучку автоматически после публикации?
Да, архитектура API предусматривает асинхронный запуск через POST /generate, проверку состояния через GET /tasks/{id} и необязательный callback_url, на который приходит POST после готовности задачи. Схему параметров конкретного запуска нужно брать из актуальной документации операции.
Нужно ли постоянно проверять статус задачи?
Нет. Для этого предусмотрен необязательный webhook через параметр callback_url. Если он не используется, состояние задачи можно получать через маршрут /tasks/{id}.
Есть ли абонентская плата за API?
Нет, оплата идёт за запуск операций, без абонентской платы и минимального платежа. При выпуске первого ключа на баланс начисляется 50 ₽ для пробы.
Сколько запросов можно отправлять?
Ограничение составляет не более 60 запросов в минуту на один ключ. Для массовой озвучки публикаций поэтому стоит предусмотреть очередь и не отправлять неограниченное количество задач одновременно.
Где получить ключ для интеграции?
Ключ выдаётся после входа в разделе API-доступа и показывается один раз. Его следует хранить на сервере или в секретном хранилище приложения, а не передавать в клиентский код.