 Genius-bot · 10 минут чтения
API распознавания речи позволяет вынести расшифровку созвона из ручной работы в отдельный шаг вашего скрипта: запись отправляется на обработку, задача выполняется, а результат можно забрать через API. Для рабочего процесса этого достаточно, чтобы связать стенограмму с последующим формированием протокола встречи.
В этой схеме нейросеть используется не только для получения текста. Один сценарий может включать загрузку записи, запуск операции распознавания, ожидание результата, передачу текста в чат для краткого резюме и сохранение готового протокола в архиве. Ключ и текущие параметры API доступны в разделе API.
 Что нужно от протокола, а не от стенограммы
Стенограмма отвечает на вопрос «что было сказано», а протокол — «что по итогам встречи нужно сделать». Для рабочих созвонов это разные результаты. В длинной расшифровке могут быть приветствия, уточнения, повторения и обсуждение нескольких вариантов, тогда как в протоколе обычно нужны решения, задачи, ответственные и сроки.
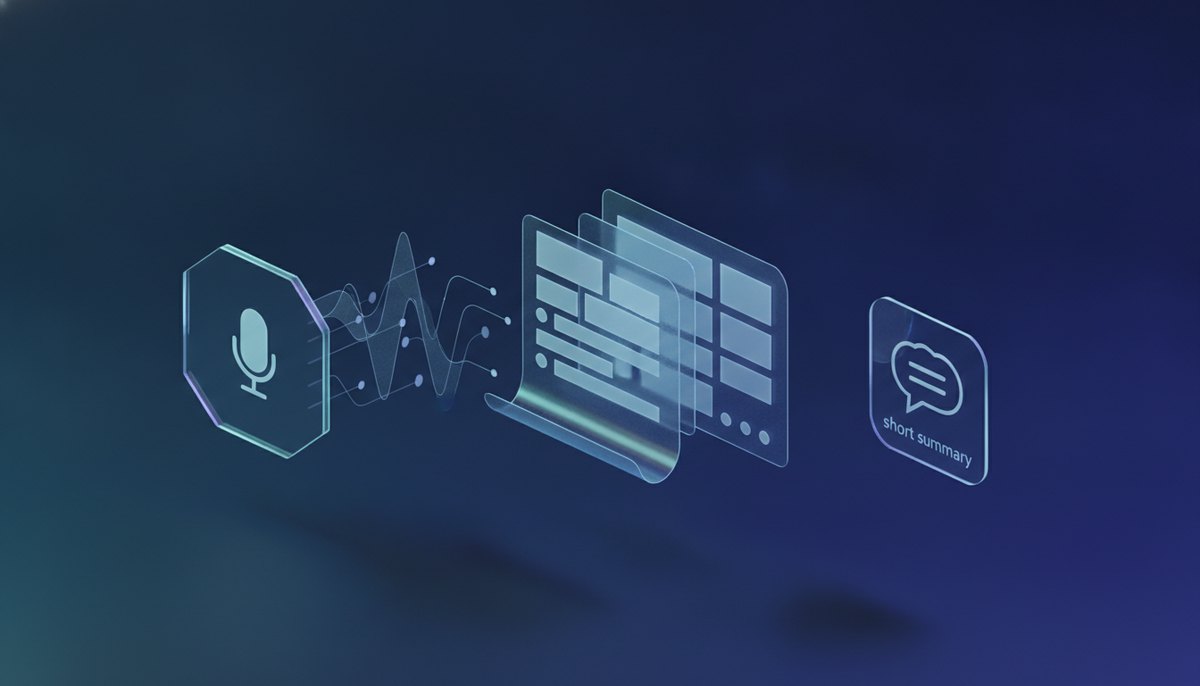
Поэтому я бы разделял процесс на два независимых этапа. Сначала api распознавания речи превращает аудиозапись в текст с сохранением информации о говорящих, затем чат обрабатывает этот текст по заранее заданной структуре.
Например, исходная стенограмма может занимать 40 минут разговора и содержать несколько тысяч слов. В итоговом документе достаточно оставить четыре блока: «Решения», «Задачи», «Ответственные», «Открытые вопросы». Это сокращает материал не за счёт удаления исходной записи, а за счёт создания отдельного рабочего представления.
Практический конвейер выглядит так:
- получить запись созвона;
- загрузить файл через
POST /uploadsи получить ссылку; - запустить операцию расшифровки через
POST /generate; - получить состояние задачи через
GET /tasks/{id}либо дождаться webhook; - передать готовую стенограмму в чат;
- сохранить краткий протокол вместе с исходной расшифровкой.
Оплата в таком сценарии идёт за запуск операции, без абонентской платы и минимального платежа. Операция «Расшифровка записи (stt)» стоит 10 ₽ за один запуск.
 Запись созвона: форматы и подготовка
До отправки файла стоит определить, что именно будет входом в процесс. Если встреча записывается целиком, в архиве полезно хранить исходный файл, дату, название встречи и идентификатор задачи распознавания. Тогда готовый протокол не становится единственной копией информации.
Маршрут POST /uploads предназначен для загрузки файла и получения ссылки. После этого ссылка может использоваться в следующем этапе сценария. Точный набор параметров операции следует брать из ответа GET /services, поскольку в справке API не задан универсальный формат тела запроса для всех операций.
Перед интеграцией удобно один раз запросить список доступных операций и цен:
curl https://genius-bot.ru/wp-json/genius/v1/services \
  -H "Authorization: Bearer <ключ>"
Авторизация выполняется через заголовок Authorization: Bearer <ключ>. Ключ выдаётся после входа в разделе API и показывается один раз, поэтому его не стоит помещать непосредственно в исходный код приложения.
В Python базовую проверку соединения можно сделать отдельно от загрузки файлов:
import os
import requests

BASE_URL = "https://genius-bot.ru/wp-json/genius/v1"
API_KEY = os.environ["GENIUS_API_KEY"]

headers = {
    "Authorization": f"Bearer {API_KEY}"
}

response = requests.get(
    f"{BASE_URL}/balance",
    headers=headers,
    timeout=30
)
response.raise_for_status()

print(response.json())
Такой запрос использует документированный маршрут GET /balance и позволяет проверить остаток до запуска обработки. Саму загрузку и запуск лучше строить по схеме параметров, которую API возвращает для нужной операции через /services, а не зашивать предположительный формат JSON.
Для записи созвона также полезно заранее договориться о длительности и правилах хранения. Если файл нужен только для автоматической обработки, после успешного формирования архива его можно хранить по внутренней политике проекта. Если же протокол должен подтверждаться по первоисточнику, исходную запись и стенограмму разумно сохранять вместе.
Расшифровка с разделением по говорящим
Обычная стенограмма без разделения участников плохо подходит для протокола. Фраза «сделаем это к пятнице» имеет смысл только тогда, когда из контекста понятно, кто её произнёс и к кому относится действие.
Поэтому при проектировании процесса разделение по говорящим стоит считать отдельным требованием к результату. Операция stt предназначена для расшифровки записи, а конкретные параметры запуска нужно получить из описания операции в GET /services.
Сам API работает с задачами: после запуска операции приложение получает идентификатор задачи, а состояние и результат можно получать через GET /tasks/{id}. Это позволяет не держать HTTP-соединение открытым на всё время обработки аудио.
Для небольшого внутреннего скрипта подходит обычный цикл опроса. Логика здесь простая: запустить задачу, сохранить её идентификатор, периодически запрашивать состояние и продолжить обработку только после получения результата.
import os
import time
import requests

BASE_URL = "https://genius-bot.ru/wp-json/genius/v1"
HEADERS = {
    "Authorization": f"Bearer {os.environ['GENIUS_API_KEY']}"
}

# После POST /generate сохраните идентификатор созданной задачи.
task_id = "ID_ЗАДАЧИ"

while True:
    r = requests.get(
        f"{BASE_URL}/tasks/{task_id}",
        headers=HEADERS,
        timeout=30
    )
    r.raise_for_status()
    task = r.json()

    print(task)

    # Здесь проверяется фактическое состояние,
    # возвращаемое вашим API для этой задачи.
    if task.get("result") is not None:
        transcript = task["result"]
        break

    time.sleep(3)
В примере намеренно не зафиксированы придуманные значения статусов: API должен быть источником фактической структуры ответа конкретной операции. Если приложение не должно заниматься постоянным опросом, у /generate предусмотрен необязательный параметр callback_url. После готовности задачи на этот адрес приходит POST.
Для автоматической обработки архива webhook удобнее polling: сервис получает уведомление о готовом результате, извлекает расшифровку, запускает следующий этап и записывает результат. При этом стоит учитывать ограничение частоты — не больше 60 запросов в минуту на один ключ.
Короткий протокол из длинной стенограммы
После распознавания у нас есть текст, но это ещё не протокол. Следующий шаг можно выполнять в том же приложении через совместимый с OpenAI формат POST /chat/completions. Для него достаточно использовать тот же формат запросов, что и у OpenAI-клиента, заменив base_url и ключ.
Вместо свободного запроса лучше задавать фиксированную структуру результата. Например, инструкция для чата может требовать вывести только четыре раздела: решения, задачи, ответственные и открытые вопросы. Это уменьшает количество ручной обработки и делает документы разных встреч похожими друг на друга.
Полезно отдельно указать правило для неопределённости: если в стенограмме нет ответственного или срока, модель не должна их придумывать. В протоколе можно оставить «не указан» или перенести пункт в «Открытые вопросы». Это особенно важно для задач, где один неточный вывод может превратиться в неверную запись в системе.
Связка выглядит следующим образом: stt создаёт исходный текст, а чат сокращает его до рабочего документа. Такой подход удобнее, чем пытаться получить сразу красивый протокол из аудио, поскольку промежуточная стенограмма остаётся доступной для проверки.
Для чата действует отдельный тариф: 40 ₽ за 1 млн токенов запроса и 400 ₽ за 1 млн токенов ответа. Поэтому при большом архиве стоит учитывать не только количество расшифровок, но и объём текста, который вы отправляете на второй этап.
| Операция | Цена | Роль в сценарии |
|---|---|---|
| Расшифровка записи (stt) | 10 ₽ за запуск | Получение текста встречи |
| Чат | 40 ₽ / 1 млн входных токенов; 400 ₽ / 1 млн выходных | Сокращение стенограммы до протокола |
| Звук из видео (ytaudio) | 0 ₽ за запуск | Получение звуковой дорожки из видео, если она нужна в процессе |
Здесь важно не смешивать две разные величины. Для stt цена указана за запуск операции, а для чата стоимость зависит от количества токенов запроса и ответа. Поэтому стоимость месяца встреч зависит от количества записей и от объёма текста, передаваемого на этап формирования протокола.
Поиск по архиву встреч
Когда встреч становится несколько десятков, простого каталога файлов уже недостаточно. Я бы сохранял как минимум дату встречи, название, участников, ссылку на исходную запись, идентификатор задачи, полную расшифровку и короткий протокол.
При этом поиск лучше строить не только по полному тексту. Отдельное поле с решениями позволяет быстро находить встречи, где обсуждался конкретный вопрос, а список задач — проверять, на каких встречах появилось определённое обязательство.
Само хранение и поиск по архиву не требуют отдельной операции API из описанного набора маршрутов. Это задача вашего приложения: после получения результата через /tasks/{id} вы сохраняете текст и метаданные в выбранное хранилище, а затем индексируете их для поиска.
Полезный формат записи может выглядеть так:
{
  "date": "2026-09-21",
  "title": "Еженедельный созвон команды",
  "task_id": "12345",
  "transcript": "...",
  "protocol": {
    "decisions": ["..."],
    "tasks": ["..."],
    "open_questions": ["..."]
  }
}
Такой JSON — это структура хранения на стороне приложения, а не формат ответа API. Её преимущество в том, что стенограмма и краткий результат остаются связанными одним объектом.
Для поиска по смыслу можно использовать сам текст встречи как вход следующего запроса к чату, но для регулярного архива сначала стоит реализовать обычный полнотекстовый поиск. Он проще для отладки: если пользователь ищет конкретное название проекта, фамилию или термин, можно сразу увидеть исходный фрагмент стенограммы.
Отдельно стоит хранить ссылку на исходную запись. Тогда спорный пункт протокола можно проверить по аудио, а не пытаться восстановить контекст только по сокращённому тексту.

Сколько стоит месяц созвонов
Рассчитаем простой сценарий: 20 встреч за месяц, по одной записи на встречу. Только этап расшифровки обойдётся в 20 × 10 ₽ = 200 ₽, если на каждую встречу приходится один запуск операции stt.
Дальше добавляется обработка стенограмм через чат. Её стоимость нельзя корректно назвать одной фиксированной суммой без объёма текста: тариф составляет 40 ₽ за 1 млн токенов входа и 400 ₽ за 1 млн токенов выхода.
Например, если ваш сценарий передаёт в чат суммарно 2 млн входных токенов и получает 100 тысяч токенов ответа, расчёт будет таким: 2 × 40 ₽ = 80 ₽ за вход и 0,1 × 400 ₽ = 40 ₽ за выход. Вместе с 200 ₽ за двадцать запусков stt получается 320 ₽ за указанные объёмы обработки.
Это именно пример расчёта, а не фиксированная стоимость месяца: фактический расход зависит от количества встреч, числа запусков stt и объёма токенов на этапе протоколирования.
При планировании бюджета удобно считать отдельно две части:
 количество записей × 10 ₽ за запуск stt;
- объём входных токенов × 40 ₽ за 1 млн плюс объём выходных токенов × 400 ₽ за 1 млн.
Абонентской платы и минимального платежа нет. При выпуске первого ключа на баланс начисляется 50 ₽ для пробы, поэтому первоначальную проверку небольшого сценария можно провести до расчёта регулярной нагрузки.
Если приложение обрабатывает большой архив автоматически, дополнительно учитывайте лимит 60 запросов в минуту на ключ. При последовательной обработке встреч это обычно означает, что основной вопрос связан не с количеством запросов к API, а с правильной организацией ожидания задач и webhook. В любом случае лимит нужно учитывать в очереди обработки.
В результате рабочий сценарий получается достаточно прямым: запись попадает в загрузку, stt создаёт расшифровку, задача возвращает результат, чат превращает длинный текст в протокол, а приложение сохраняет оба документа в архиве. При следующей встрече этот же конвейер запускается снова, а поиск работает уже по накопленной базе.
 Частые вопросы
Можно ли получить результат расшифровки без постоянного опроса API?
Да. Для запуска операции предусмотрен необязательный параметр callback_url. Когда задача готова, на указанный адрес приходит POST. Альтернативный вариант — периодически запрашивать GET /tasks/{id}.
Сколько стоит одна расшифровка?
Операция «Расшифровка записи (stt)» стоит 10 ₽ за один запуск. Это цена операции, а не тариф за минуту аудио.
Можно ли после расшифровки автоматически сделать короткий протокол?
Да, архитектура сценария позволяет разделить эти этапы. Расшифровка выполняется через stt, после чего полученный текст можно передать в POST /chat/completions и задать ему структуру итогового документа.
Как узнать параметры запуска операции?
Маршрут GET /services возвращает список операций и цен. Для конкретной интеграции параметры запуска следует брать из описания операции, а не предполагать общий формат тела для всех методов.
Нужно ли хранить только протокол встречи?
Для рабочего архива практичнее сохранять и краткий протокол, и полную стенограмму, а при необходимости — ссылку на исходную запись. Тогда спорный пункт можно проверить по исходному материалу.
Где взять ключ для API?
После входа ключ выдаётся в личном разделе API. Он показывается один раз, поэтому в приложении его лучше хранить как секрет и передавать через заголовок Authorization: Bearer <ключ>.